本文目录
摘要:本文介绍推荐系统中召回阶段的核心技术,包括双塔模型、正负样本构建策略、负采样技巧、线上召回架构、Deep Retrieval 等。
一、召回阶段的作用
推荐系统的召回阶段负责从百万级候选池中快速筛选出千级候选,送入后续的粗排和精排。
百万级物品 → 召回策略(多路) → 千级候选 → 粗排 → 精排
召回的核心要求是:高召回率 + 低延迟,宁可多放几个可疑的,也不能漏掉用户感兴趣的。
二、双塔模型与 DSSM
2.1 核心思想
DSSM 原论文学习的是搜索 query 与 document 的语义匹配,是双编码器思路的代表,不能把所有双塔推荐模型都视为同一个 DSSM 实现。迁移到推荐场景时,双塔模型将用户和物品分别编码为向量,通过向量相似度(常见的是内积或余弦相似度)来衡量匹配程度:
用户特征 → [用户塔] → User Embedding (128维)
                                   ↓
                              cos(u, v)
                                   ↓
物品特征 → [物品塔] → Item Embedding (128维)
这样做的好处是:物品向量可以预先计算并存储,在线召回时只需计算用户向量,然后做最近邻搜索。
2.2 训练方式
Pointwise(点对点)
将每个用户-物品对视为一个独立的二分类样本:
- 正样本具有较高匹配分数,负样本具有较低匹配分数
- 通常将单个 pair 的分数经 sigmoid 变为二分类概率;如果改为在一个候选集合上做 softmax/对比损失,就已经是集合式或 listwise 训练,而不再是严格的 pointwise 二分类
- 正负样本比例没有通用固定值,应结合采样策略、批大小与线上分布验证
用户 u ──▶ 正样本物品 v+  → 标签 1
用户 u ──▶ 负样本物品 v-  → 标签 0
Pairwise(成对比较)
每次取一个正样本和一个负样本,学习让正样本的相似度大于负样本:
-
Triplet Hinge Loss: \(L = \max(0, \cos(u, v^-) + m - \cos(u, v^+))\) 其中 $m>0$ 是 margin;具体取值取决于相似度范围、负样本挖掘策略与数据分布,应通过验证集选择。
-
Triplet Logistic Loss: 令 $s^+=\cos(u,v^+)$、$s^-=\cos(u,v^-)$,把上面的 hinge 函数用 softplus 平滑后可写为: \(L = \log\left(1 + \exp\left[\alpha(m+s^- - s^+)\right]\right) = \operatorname{softplus}\left(\alpha(m+s^- - s^+)\right)\) 这里 $m$ 与 Hinge Loss 中一样控制正负样本所需的分数间隔,$\alpha>0$ 是可选的缩放系数;省略缩放时取 $\alpha=1$。$m=0$ 会退化为无显式 margin 的 pairwise logistic loss。原式使用了未定义的 $\sigma$:若它表示 sigmoid,就不应再嵌套到指数中;若它原本想表示温度或尺度,也应像这里一样明确写成标量,因为 $\log(1+\exp(z))$ 本身就是对 $\max(0,z)$ 的平滑近似。
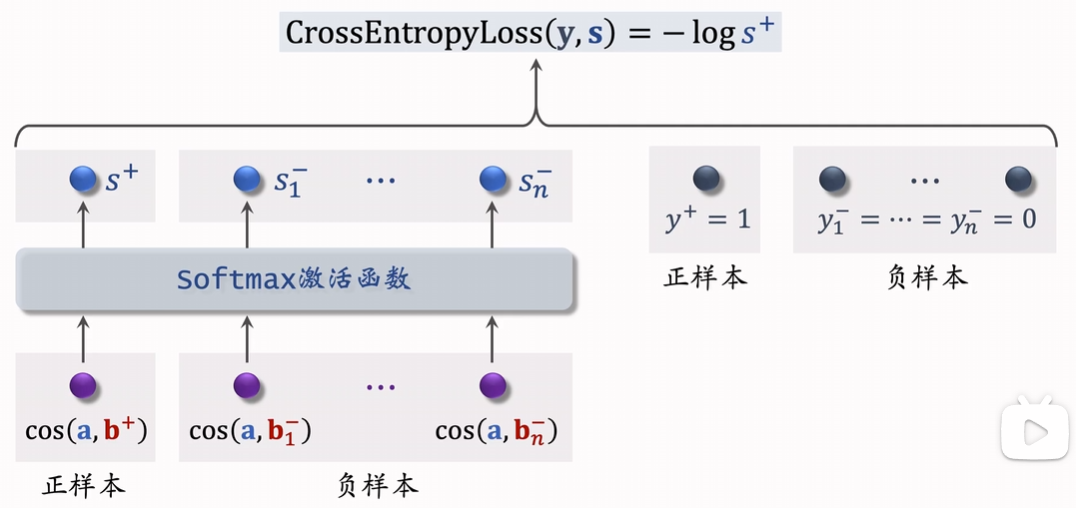
Listwise(列表比较)
每次取一个正样本和多个负样本,学习正样本在列表中的排名:
2.3 属性处理方法
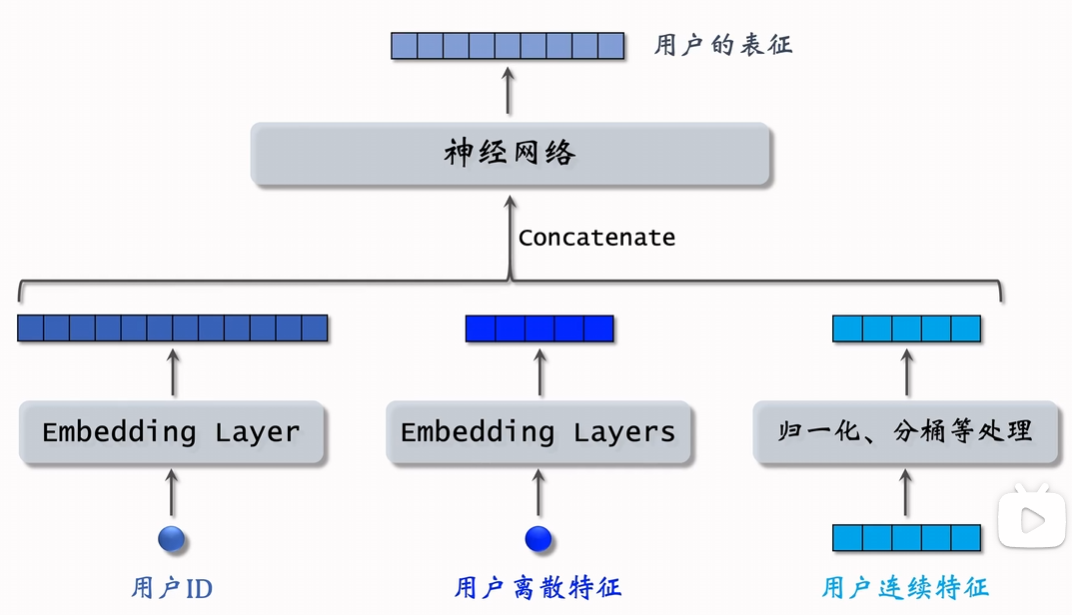
不同特征需要不同的处理方式:
- 连续特征:归一化或分桶
- 类别特征:Embedding 编码
- 序列特征:Attention 池化或 RNN 编码
三、正负样本构建
3.1 正样本
以 CTR 召回为例,常把曝光且有点击的用户—物品二元组作为正样本。若业务目标是播放、收藏或成交,正样本定义应随目标改变,不能把“点击”当作所有召回任务唯一的正反馈。
注意事项:
- 可以根据目标对冷门物品过采样或对热门物品降采样,减少热门物品主导训练的程度
- 这会改变训练分布,是否采用以及是否需要重要性权重,应由离线召回指标、校准和线上实验决定,而不是作为固定规则
3.2 负样本
负样本分为三类,构建策略各有不同:
简单负样本(未被召回)
直接从全体物品中抽样:
- 均匀抽样:每个物品概率相同;在长尾目录中,大量被抽到的往往是容易区分的冷门物品,而热门或相似的困难负样本可能不足
- 非均匀抽样:抽样概率可与热门程度正相关;点击次数的 0.75 次方来自 Word2Vec 的经验性负采样设计,是可调启发式,不是推荐模型通用的最优指数
# 负采样概率
p(item_i) = count_i^0.75 / Σ count_j^0.75
困难负样本(召回但被淘汰)
这些物品被召回了,但在粗排或精排中被淘汰,没有被曝光。它们通常比随机负样本更有区分度,但“未曝光”意味着无法观察用户是否真的不喜欢,其中还可能混入假负样本。实践中需要控制挖掘来源和难度,避免模型只学习上一版系统的偏差。
Batch 内负样本
将同一个 batch 中其他正样本的物品作为负样本:
- 问题:其他样本的正例会按训练流中的出现分布成为负例,热门物品通常更常出现,因而被更频繁地当作负样本;这个分布不一定严格等于全局点击次数分布
- 常见缓解方法是 logQ correction:若相似度 logit 为 $s(u,v_i)$、物品进入负样本集合的概率估计为 $p_i$,训练 softmax 使用 $s(u,v_i)-\log p_i$。这是训练损失中的采样偏差修正,线上向量检索仍使用 $s(u,v_i)$。经典 logQ 能降低偏差,但其结论依赖采样模型和概率估计;后续研究也指出,若把必然出现的正样本与随机负样本完全同样修正,仍可能残留偏差,因此不应把这一行公式描述成对所有 in-batch loss 的精确无偏解
曝光未点击
被曝光但用户没有点击的物品包含较强的负反馈信号,常用于排序训练;召回模型也可以使用,但需要处理位置偏差、曝光机制偏差和“未点击不等于不感兴趣”的噪声,不能直接当作无偏负样本。
四、线上召回架构
用户请求 → [用户塔] → 实时计算 User Embedding
                                ↓
                    ┌─────────────────────┐
                    │  向量检索引擎        │
                    │  (Milvus / Faiss)   │
                    │  存储预计算的       │
                    │  Item Embedding     │
                    └─────────────────────┘
                                ↓
                        Top-K 召回结果
关键设计
- 用户塔在线或近线计算:包含实时上下文时通常需要请求时计算;仅依赖较稳定历史特征时,也可以预计算并短期缓存,在新行为到达后刷新
- 物品塔预计算:物品侧特征相对稳定时可以离线建库,但更新频率应随内容发布、特征变化和一致性要求确定,而不是固定为每天或每小时
- 向量检索引擎:使用 Faiss、Milvus 或 HnswLib 做最近邻搜索
五、模型更新
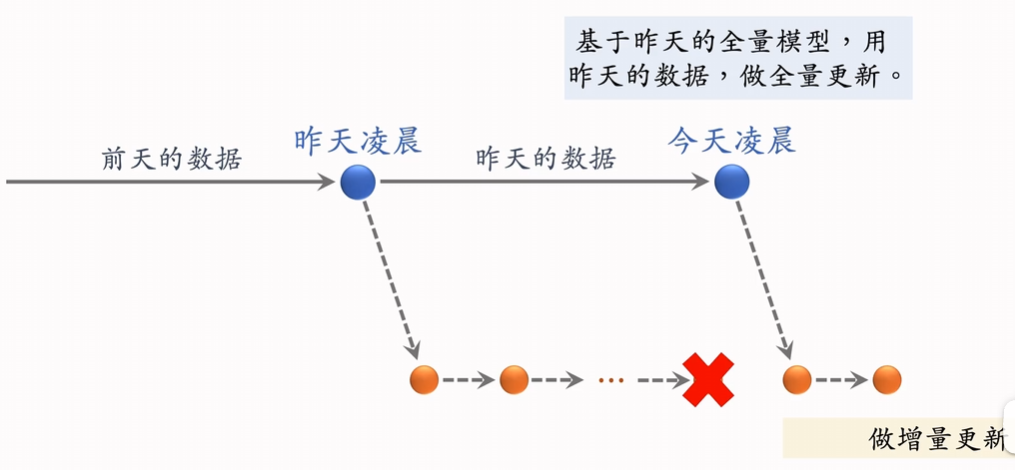
5.1 一种周期全量更新策略
- 例如每天使用前一时间窗的数据训练或微调模型
- 可以从上一版本参数热启动,也可以按需要重新训练
- epoch 数、窗口长度与打乱方式都是实验和资源约束下的选择
- 相比流式更新,对数据流和系统的要求通常较低
5.2 一种增量更新(Online Learning)策略
- 实时收集线上数据,做流式处理
- 样本可以写入 TFRecord 等训练格式,也可以直接进入流式训练管线;TFRecord 不是在线学习的定义条件
- 可以只更新用户 embedding,也可以更新物品 embedding、部分网络或全模型;增量参数是否合回全量模型取决于版本与一致性设计
- 若只使用很短时间窗,容易受到样本量、延迟标签和短期分布波动影响
- 优点:能快速响应用户兴趣变化
5.3 两者的权衡
| 维度 | 全量更新 | 增量更新 |
|---|---|---|
| 数据量 | 较长周期窗口 | 较短时间窗口或数据流 |
| 训练稳定性 | 通常较高 | 更易受短期波动影响 |
| 实时性 | 低(T+1) | 高(分钟级) |
| 适用场景 | 通用召回 | 兴趣变化快的场景 |
一种常见组合是用周期训练提供稳定基线,再用增量更新响应近期变化;是否需要两套路径、更新哪些参数以及如何合并版本,应由新鲜度目标和运维成本决定。
六、无标注预训练与数据增强
在缺乏人工标注时,可以从物品自身构造重建或对比目标来预训练物品塔。需要注意,mask 或 dropout 只是构造输入扰动;只有同时定义“预测被遮盖内容”或“拉近同一物品不同视图”等学习目标,才形成完整的自监督任务:
| 方法 | 描述 |
|---|---|
| Random Mask | 随机 mask 部分特征,以预测或重建被遮盖内容为训练目标 |
| Dropout 视图 | 对同一物品生成两份随机扰动视图,再配合对比或一致性损失;单独做 dropout 不是自监督标签 |
| 互补特征 | 使用同一物品的不同特征视图做对比学习 |
| Mask 关联特征 | 将一组关联特征同时 mask,再从其余特征预测它们,学习跨特征关联 |
七、其他召回策略
7.1 Deep Retrieval 召回
Gao 等人提出的 Deep Retrieval 联合学习离散编码结构与物品到路径的映射。结构有 $D$ 层,每层 $K$ 个节点;路径 $c=(c_1,\ldots,c_D)$ 在每层选择一个节点,共有 $K^D$ 种可能的路径。给定用户特征 $u$,模型按前面的编码选择,逐层预测下一层节点的条件概率:
\[p(c\mid u)=\prod_{d=1}^{D}p(c_d\mid u,c_1,\ldots,c_{d-1})\]推理时使用 Beam Search,每层只保留束宽允许的高概率路径前缀,完成后取这些路径关联的物品,合并去重并交给后续排序。束宽在搜索成本与候选覆盖之间做折中,并不保证找到全部全局最优路径。
这里的路径对应物品簇:同一路径可以关联多个物品,一个物品也可以关联多条路径;不同路径还可以共享某一层的节点。因此,DR 的离散结构没有“一件物品对应一个叶节点”的设定,应与 TDM/JTM 一类物品树区分。Beam Search 可以用于这两类结构,但搜索算法相同并不意味着索引结构相同。
7.2 地理位置召回
- GeoHash 召回:将经纬度编码为 GeoHash,查询所在网格及必要的相邻网格,再按真实距离过滤;只查同一网格会漏掉跨网格边界但距离很近的物品
- 同城召回:直接召回用户所在城市或附近的物品
7.3 作者召回
召回用户关注/喜欢的作者发布的新内容。适用于社交属性强的产品。
7.4 曝光过滤
可以使用 Bloom Filter 记录用户已经看过的物品,在召回阶段过滤重复曝光。对只插入、不删除且实现正确的标准 Bloom Filter,查询没有假阴性,但存在假阳性:少量从未看过的物品也可能被误判为“看过”而遭到过滤,因此容量和误判率必须纳入设计。
八、总结
召回阶段的关键要点:
- 双塔模型:将用户和物品映射到同一向量空间,支持快速检索
- 负样本构建:简单负样本 + 困难负样本 + Batch 内负样本,多管齐下
- 线上架构:按特征新鲜度选择实时计算、缓存或预计算,再接向量检索引擎
- 模型更新:在周期训练与增量训练之间权衡稳定性、实时性和系统复杂度
九、参考资料
- Schroff et al., FaceNet: A Unified Embedding for Face Recognition and Clustering
- Rendle et al., BPR: Bayesian Personalized Ranking from Implicit Feedback
- Huang et al., Learning Deep Structured Semantic Models for Web Search using Clickthrough Data
- Mikolov et al., Distributed Representations of Words and Phrases and their Compositionality
- Yi et al., Sampling-Bias-Corrected Neural Modeling for Large Corpus Item Recommendations
- Khrylchenko et al., Correcting the LogQ Correction: Revisiting Sampled Softmax for Large-Scale Retrieval
- Gao et al., Deep Retrieval: Learning A Retrievable Structure for Large-Scale Recommendations
相关文章:
觉得有帮助?
分享给同样关注系统性能的人。